写论文卡壳时,你是不是也想过把文献全扔给 AI,再搭三五个 Agent 让它们自己讨论出初稿?但 Google 在 2026 年做了一项涵盖 180 种 Agent 配置的受控研究,结果让人意想不到:在有顺序依赖的科研任务上,多 Agent 不仅没提效,表现反而下降了。
这跟我们每天在X 上刷到的教程完全相反。
在很多讲 AI 辅助科研的教程中,到处都在教你怎么把一个长提示词拆成“检索员、撰稿人、审稿人”五个角色。
好像只要让模型左手倒右手互相聊上十轮,出来的东西就能直接投顶刊。
作为一个既不是计算机科班出身、也不会写复杂底层框架的普通研究者,我决定不看任何厂商宣传稿,自己与导师把这些 AI 用真实场景试一试。
截至十月底,我把能找到的原始研究论文、官方技术文档、独立评测机构 Epoch 的基准数据,还有 32 项传统科研方法与工具原始来源翻了个底朝天,今天决定把这套“建立AI 辅助科研体系”的心得无偿奉献给各位。
为什么让两个 AI 互相讨论,不等于科研验证?
我们先看证据。
为什么你觉得 Deep Research 或多智能体写出来的报告像模像样,发给导师却被骂得狗血淋头?
我把 2026 年发布的《Deep Research Bench II》(arXiv:2601.08536)和《DeepResearch Bench》(arXiv:2506.11763)两篇独立评测论文从头到尾过了一遍,我看不懂底层的算法细节,但老老实实去核对了它们的测试任务数、评测打分口径,还专门翻到了论文后半部分的局限说明那一章。
结果显示,哪怕是 2026 年最强的 Deep Research 系统,在面对专家级开放研究任务时,依然存在明显的覆盖遗漏、忠实引用缺口和事实一致性错误。
有链接,不代表那个链接真的支持它写出来的那句话。
更让人意想不到的是,多模型协作依然无法解决问题。
Google 有一项针对 180 组 Agent 配置的研究明确指出,多 Agent 只对可以并行拆分的任务有利。一旦任务存在强顺序依赖——比如科研里“先界定问题、再筛文献、再推导、再验证”——协调本身就会产生损耗,甚至放大错误。
两个模型完全可能共享同一个错误来源、相似的训练语料,或者同一批检索结果。
模型 A 给个错答案,模型 B 说“我同意”,模型 C 继续附和。这不是交叉验证,这是抱团幻觉。
另一项针对科研事实核查的研究《DeepFact》(arXiv:2603.05912)给出了完全不同的路径:先生成,再由独立的审计流程去对照外部证据复核,改善效果远比让两个模型“自由讨论”可靠得多。
脱离了工具链,最强的模型能拿几分?
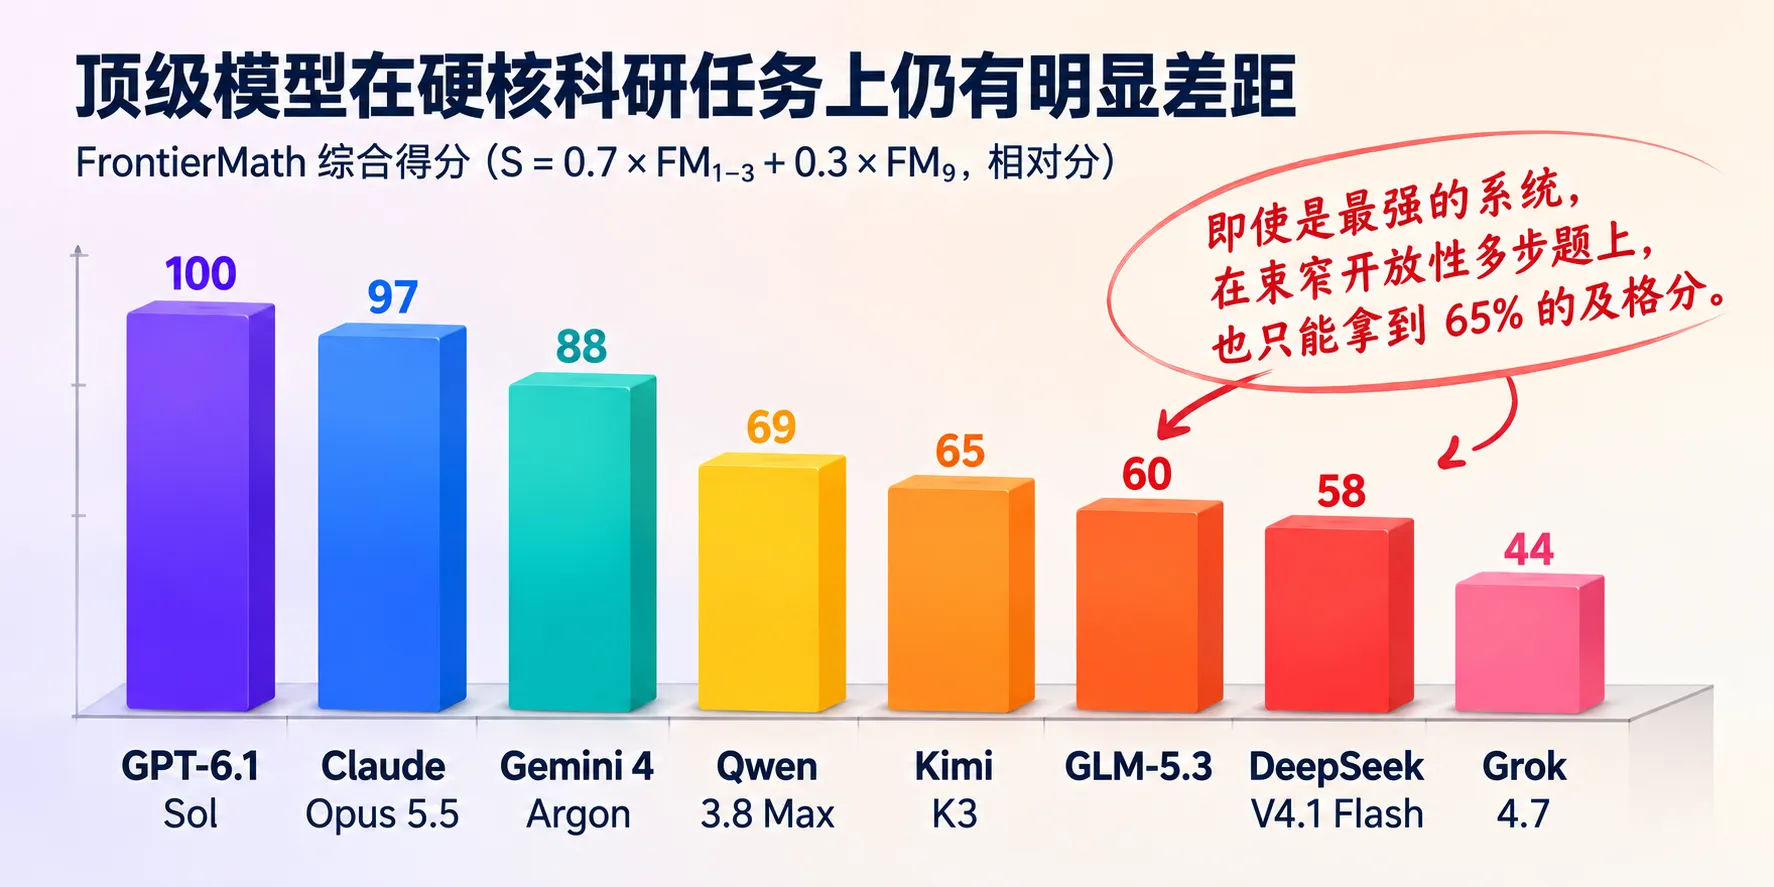
为了弄清楚 2026 年的主流模型在硬核科研任务上到底处于什么水准,我没有看那些笼统的排行榜,而是去 Epoch 官网把八家模型的原始分数一个一个抄进本地表格,自己动手算了一遍。我先按 0.7×第一档 + 0.3×第二档加权,把当前美国模型的最高分设为 100。
Epoch 这边我用了两组数据。先说第一组,测试数学与高难理工推理的 FrontierMath。
这里分两档:Tiers 1–3 v2 接近高等数学到早期研究难度,Tier 4 v2 则是专家研究级问题。
为了防止极难的 Tier 4 样本过度支配结果,我按 S = 0.7 × FM₁–₃ + 0.3 × FM₄ 的权重算出了综合得分,并把当前美国模型里的最高分设为 100 分基准。
结果差距拉得很大:
- GPT-6.1 Sol:FM 1–3 拿到 94%,FM T4 拿到 100%,相对分 100。
- Claude Opus 5.5:FM 1–3 为 91%,FM T4 为 95%,相对分 约 97。
- Gemini 4 Argon:FM 1–3 为 86%,FM T4 为 78%,相对分 约 88。
- Qwen 3.8 Max:FM 1–3 为 75%,FM T4 掉到 46%,相对分 约 69。
- Kimi K3:FM 1–3 为 72%,FM T4 为 39%,相对分 约 65。
- GLM-5.3:FM 1–3 约 69%,FM T4 约 29%,相对分 约 60(注:GLM-5.3 的数据来自 Epoch 第二层独立跟踪,缺少厂商一手发布页核实)。
- DeepSeek V4.1 Flash:FM 1–3 约 67%,FM T4 约 27%,相对分 约 58。
- Grok 4.7:FM 1–3 约 53%,FM T4 约 17%,相对分 约 44。
跑这组数据时我发现了一个有意思的现象。
如果看科学知识类的 GPQA Diamond 测试,Qwen 3.8 Max 和 Kimi K3 都拿到了 93% 的高分,几乎贴着前沿走;但一旦切到最高难度的 FrontierMath Tier 4,立刻从 93% 跌到 46% 和 39%。
单题知识储备,跟高难度的长程推导完全是两码事。
算完这版相对分,我自己心里也犯嘀咕:这个 0.7 和 0.3 是我自己拍脑袋定的,万一换个权重结论全变了怎么办?
于是我又换了三组权重重算,把第二档权重分别调成 0.5、0.1 和 0.7。
重算的结果让我心理踏实一些:不管怎么调,八家的排名一次都没变,但具体分值晃得厉害。
就拿 Qwen 3.8 Max 来说,在第二档权重最低时相对分能到 76.2,权重最高时就只剩 55.7,中间足足差了 20.5 分。
这张表能说明前三名和后面有断层,这个结论换什么权重都成立;但它说明不了「中国模型落后了百分之几十」这种具体数字,因为那个数字是选权重选出来的,不是模型跑出来的。
那如果把模型放进真实的科研工作流里呢?
我又去翻了 Epoch 十月初更新的 Automation Reports,把它的评分说明从头读到尾才意识到:这个测试不考裸模型,而是考“模型 + Agent 工具链(harness)”完成真实开放任务的能力,由人工按内部员工预期标准打分(100% 代表达到员工标准):
- GPT-6 Astra + Codex:平均分 65%(以最高值为 100 折算,得 100)。
- Claude Fable 5.1 + Claude Code:平均分 65%(折算得 100)。
- Grok 4.6 + Grok Build:平均分 59%(折算得 91)。
- Qwen 3.8 Max + Qwen Code:平均分 53%(折算得 82)。
- Kimi K3 + Kimi Code:平均分 52%(折算得 80)。
- Gemini 3.8 Flash + Antigravity:平均分 42%(折算得 65)。
在大家最关心的 Research Design(研究设计) 子项里,得分依次是 Claude 63%、GPT-6 Astra 62%、Grok 55%、Qwen 42%、Kimi 37%、Gemini 23%。
而在另一项让 Agent 自主完成机器学习与数据分析的 WeirdML v3 评测中,GPT-6 Astra 是 42.2%,Claude Opus 5.5 是 31.2%,到了 Kimi K3 就只有 7.3%,DeepSeek V4.1 Flash 只有 5.9%。
看到这里,真相已经很清楚了:哪怕是全球并列第一的顶级 Agent 系统,在真实开放任务里也只能拿到 65% 的及格分。指望它们全自动跑完科研全程,纯属不把自己的事业当回事。
我用了 15 道模拟电路题进行真实测试
算完上面那几张表,我拿着打印出来的纸去找导师,本来想顺理成章地跟他吐槽「AI 根本靠不住」。结果导师扫了一眼,回了我一句:光看别人的榜单没用,你自己出一套题。
我当天晚上就闷在工位上出了 15 道模拟电路计算题,憋着劲想抓看看,到底哪个AI 模型拉哪个夯。
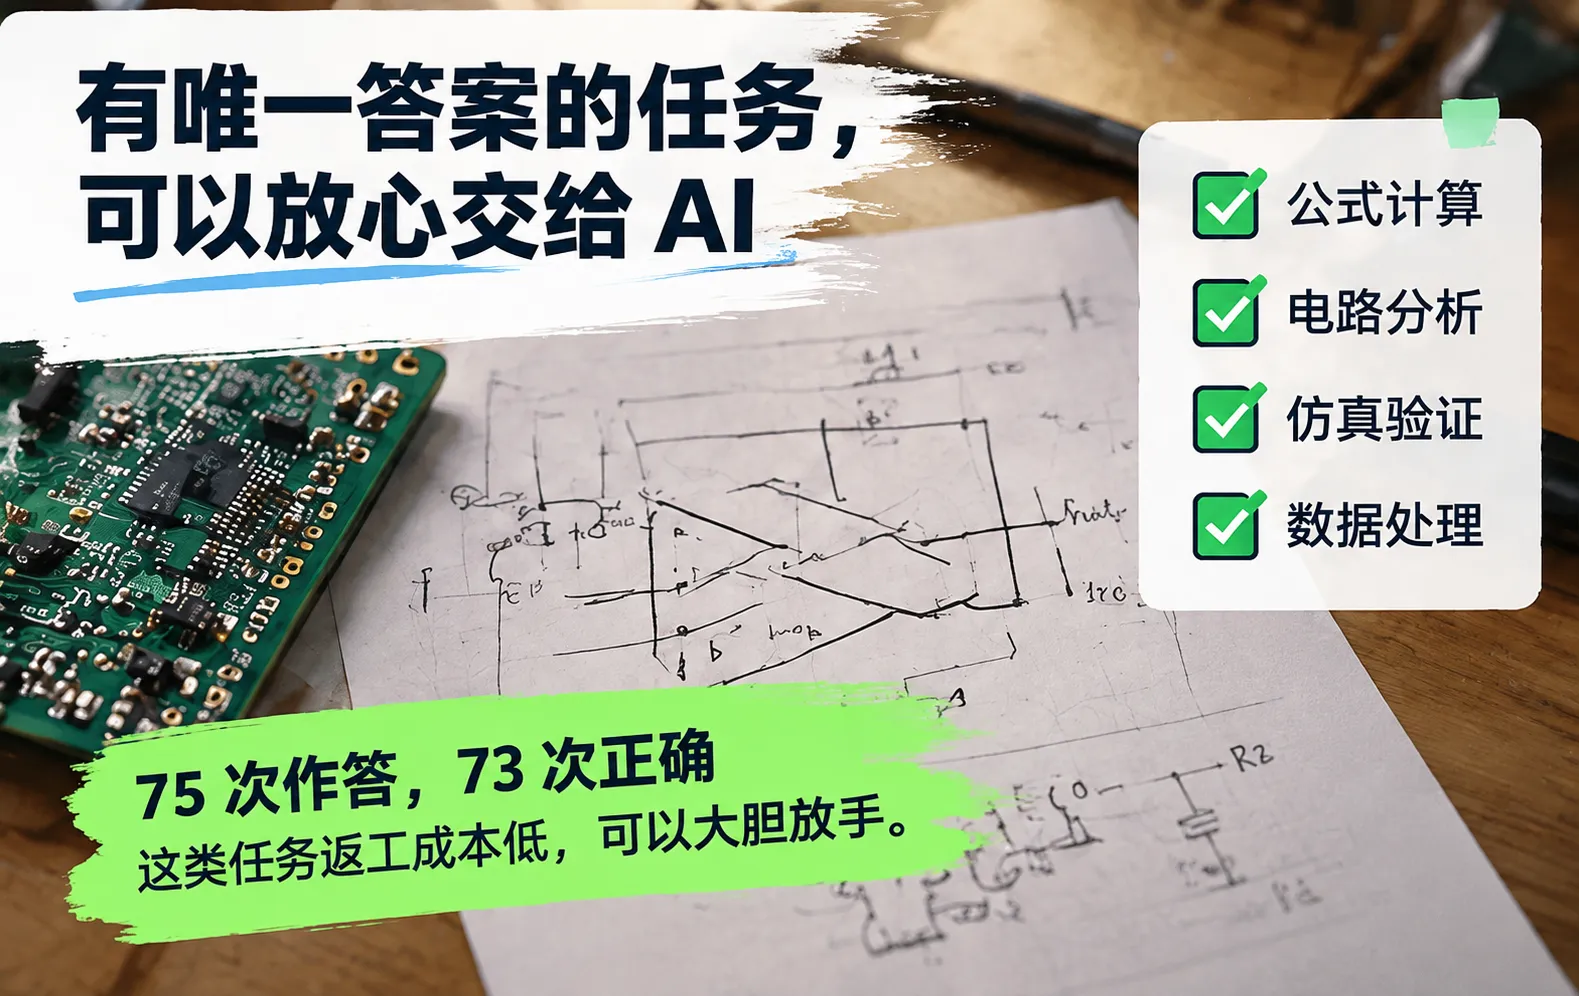
我用 10 道电子系本科基础题(共源放大器增益、RC 低通截止频率、反相运放增益、分压偏置基极电位、三极管集电极电流、同相运放增益、共射输出电阻、差分放大器 CMRR、运放闭环带宽、电阻热噪声),另外 5 道是我故意埋了工程陷阱的题(datasheet 取 min/typ/max 哪个值、压摆率够不够、两级级联后的总带宽、10 位 ADC 的 1 个 LSB、共模干扰折算到输入端的误差)。每道题都有唯一数值答案,我定死判分标准是误差 2% 以内算对。
我把题目喂给 5 个模型闭卷作答,一共 75 次作答,我原本以为至少能抓出二三十个错。结果我拿着计算器一道道对完答案,整个人傻了:75 次作答,73 次正确。全对的有四个:Gemini 4 Argon、DeepSeek V4.1 Flash、Kimi K3、GLM-5.3,都是 15 道全对,连那 5 道工程陷阱题都没跳进去。
失手两次的是MiniMax M3.1 Flash:一道 RC 低通截止频率算成 1.59kHz,正确是 15.9kHz,小数点移错,差了整整十倍;另一道电阻热噪声算出 4.07nV,正确是 128.7nV,这是直接把公式用错了。
我盯着这个成绩想了很久。难道真的这么厉害?后来我发现,厉害是真的,但它厉害的点,不是我们平时以为的那些事情。
因为这 15 道题全都能写成一个唯一答案,只要挂一个外部脚本或者跑一遍仿真,1.59kHz 和 15.9kHz 的十倍差距一秒钟就会报警。所以这组数据真正说明的不是「AI 已经很强」,而是:一件事如果有唯一答案、有外部工具能判对错,那么把它交给 AI,就算它错了你也接得住,返工成本低。这类活可以大胆放手。
反过来,如果一件事连你自己都说不清怎么算对,那么 AI 给的答案你既没法验,也没法反驳,它错得再离谱也不会报警。
当然,我只测了本机能直连的 5 个模型,OpenAI 和 Claude 系列因为账号限制调不通。而且这 15 道题也只覆盖了条件明确的计算类任务,绝不代表它们在论文写作和文献判断上有同样的水平。
为什么我拒绝给“科研”和“人文社科”科研打总分?
在整理数据时,我原本想顺手把“科研”和“人文社科”也做成 100 分的对比表,但试跑之后我全部放弃了。
这里我必须主动交代局限:上面的 0.7 和 0.3 权重只是我为了防止单样本支配而设定的个人计算方式,不是 Epoch 官方方法;而且任何单一数学或 Agent 跑分,都不能直接等同于你的真实科研成功率。
至于科研编程,Epoch 里的指标是碎的。Claude Opus 5.5 在 MirrorCode 上拿了 77%,而 Qwen 3.8 Max 给的是 SciCode 的 53%。两个测试集条件不同,直接拿 53 除以 77 算出“Qwen 是 Claude 的 69%”是典型的外行伪精确。
中文人文社科就更不能信网上的排行榜了。
到现在,根本没有任何一个高质量的独立基准,能同时覆盖 GPT-6、Claude 5.5、Gemini 4、Qwen 3.8、Kimi K3.1、MiniMax M3.1 Flash 这些新版本,去测它们的中文史料释读和引文忠实度。
而且在梳理电子科学与人文社科两个方向的科研流程时,我还踩了两个坑:
第一个坑在中文数据库。
很多人喜欢用 Elicit 或 Scite 搞文献综述。Elicit 官方声称覆盖超 1.38 亿篇论文,Scite 的 MCP 号称能访问超 2.5 亿篇学术记录。但没有任何一手证据表明它们能等价覆盖知网(CNKI)、万方、维普和国家哲学社会科学文献中心。拿纯英文工具搜中文思想史或地方政策,明显不靠谱,漏检率会非常高。
第二个坑在电子工程的电路仿真。
如果你让 Agent 去调 LTspice(当前 Windows 版为 26.1.1)的 batch 模式跑几千次参数优化,2026 年依然有用户报告它会疯狂弹出 GUI 窗口抢夺电脑焦点,根本没法干活。反而是把开源的 ngspice 编译成共享库(Shared Library),让 Python 直接在内存里装载网表、改参数、读数据,跑得既安静又稳当。
科研领域,到底应该如何判断和使用 AI
既然不能无脑自动化,到底该怎么用 AI?
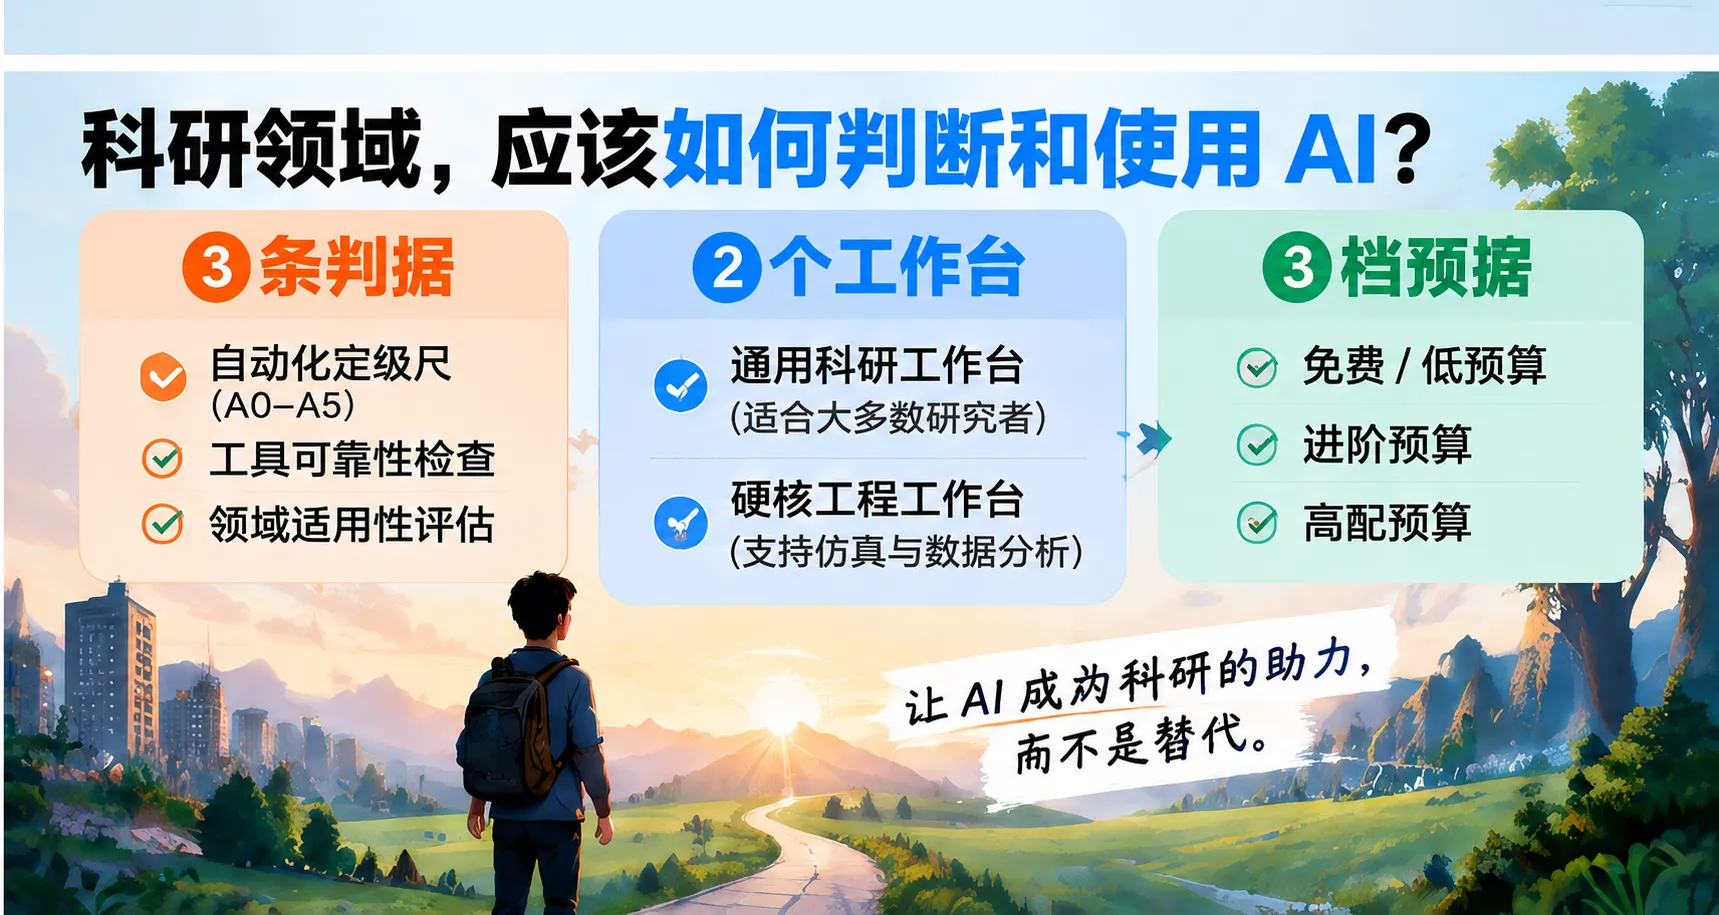
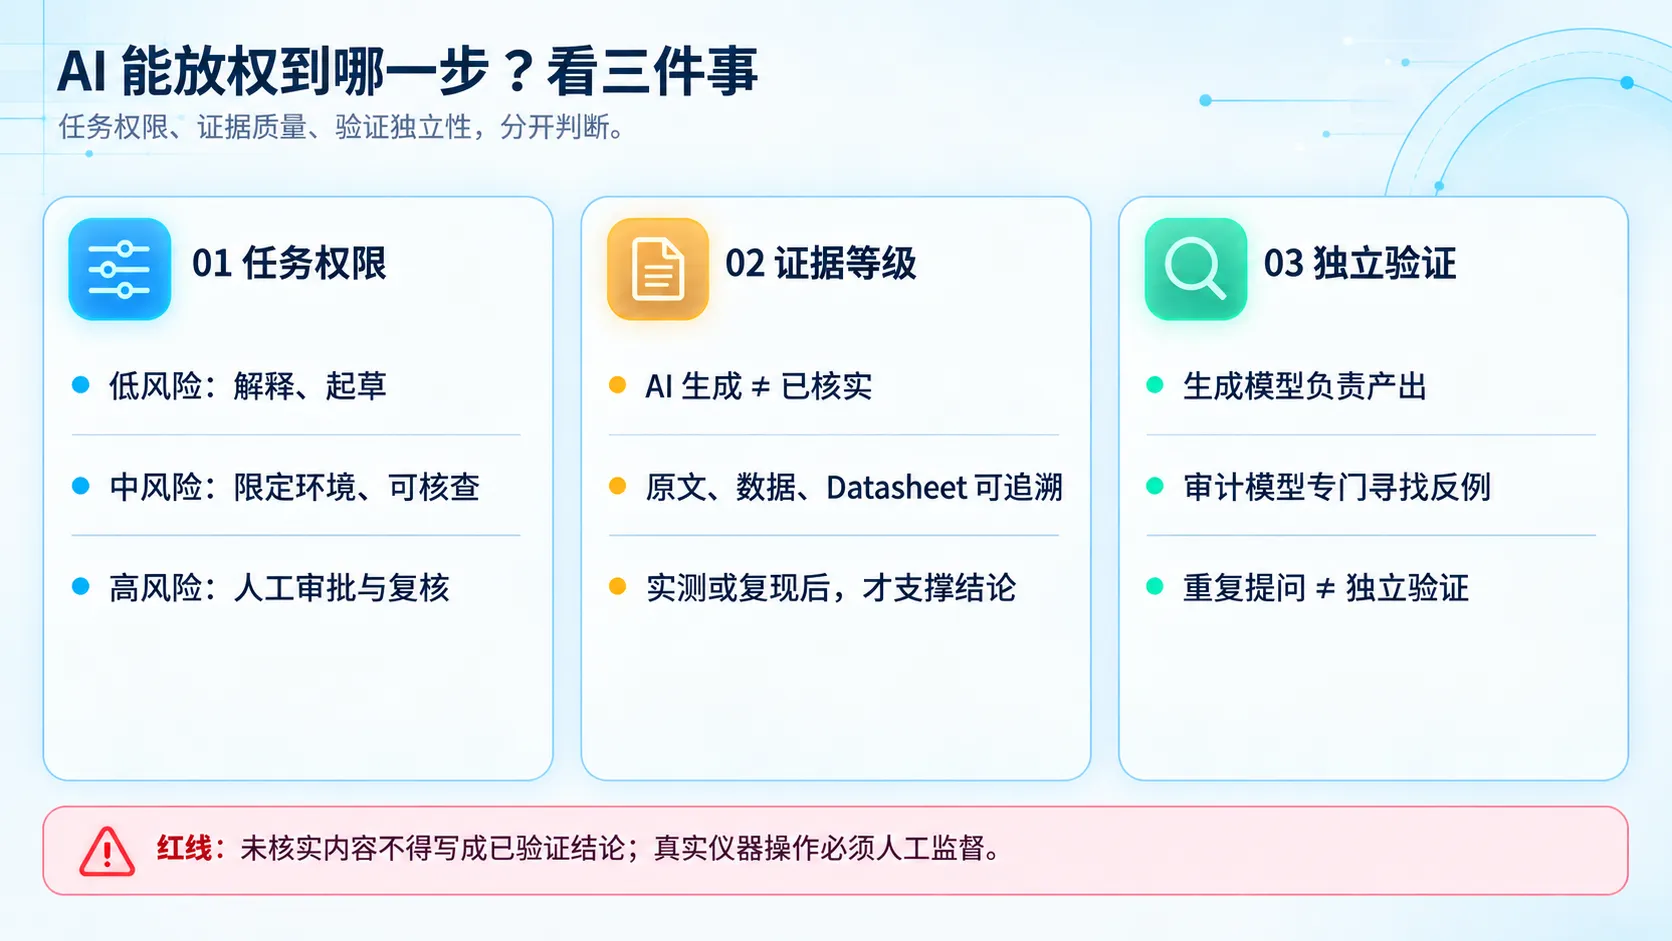
结合 Lucia Rapanotti 与 Jon Hall 今年一月发布的 468 页方法论手册《Academic Research: A Guide for the Perplexed》里的“主张—证据—验证”框架,我提炼了三条判断标准:
判据一:自动化定级尺(A0–A5 边界法) 接手任何任务前,先看它有没有“外部客观评分器”:
- A0(纯人工) 到 A1(AI 解释/起草):随时可用。
- A2(AI 在指定原文、数据库和代码环境里产出可核查结果):这是 2026 年科研的默认安全层级。
- A3(Agent 按明确验收条件跑多步) 到 A4(Agent 靠仿真/测试结果闭环改方案):只有当存在 Python 报错、SPICE 仿真、KiCad 的
kicad-cliERC 检查,或者像 MathWorks 2026 年推出的 MATLAB Agentic Toolkit(MATK-2026.09.a / MCP Server v0.13.0)这种真实执行器时,才允许放权到 A4。 - A5(自主提课题、控真实仪器、下结论):坚决禁止无人监督。比如用 PyVISA 控制真实实验设备,AI 只能写代码,必须经过“人工查 SCPI 白名单 → 发
*IDN?确认身份 → 设电压电流安全上限 → 单次验证”后,才能放行批量循环。
判据二:证据升格尺(E0–E4 准入法) 永远不要看 AI 写得顺不顺,只看这条结论处于哪个证据等级:
- E0:AI 生成,未核实 → 只能当搜索线索(比如多模态模型看 PCB 图说“U3 像 LDO”,这就是 E0)。
- E1:有真实来源,但没核对支持关系 → 只能留作内部草稿(Scite 自动标出的 supporting/contrasting 也只能算这一级,不能当真伪裁决)。
- E2:已核对原文页码、段落或器件 Datasheet 的具体版本与 min/typ/max 条件 → 可作为普通文献事实写进论文。
- E3:关键数值经过独立脚本、SPICE 仿真复算一致 → 可作为定量科研主张。
- E4:有真实仪器实测、重复实验或独立史料互证 → 才能作为核心结论发表。
记住一句话:正式科研不是要求所有句子都到 E4,而是绝不允许把 E0 和 E1 伪装成 E3 和 E4 写进正文。
判据三:异质验证尺(双模型分工法) 如果预算允许用两个模型,严禁“同一个问题问两遍取交集”。必须做异质分工:
- 模型 A(生成层):只根据你喂给它的受控文献或网表,提取结构化证据卡或写初版代码。没有
source_id和页码的句子,一律不准写“学界认为”。 - 模型 B(审计层):不准写综述,专门执行“反对任务”——去原文里找反例、找遗漏、查页码是否存在、查作者到底是在赞成还是仅仅转述反方观点。
- 数据合规红线:2026 年 1 月 1 日施行的《个人信息出境认证办法》及网信办 9 月政策问答已经非常明确。公开论文和公开政策可以按条款上云;未公开稿件、涉个人信息的访谈录音、实验室敏感数据,默认绝不上传公共境外 AI,必须先脱敏或转本地开放权重模型处理。
砍掉花哨框架后,我自己的科研工作流是怎样的?
把这套判据跑通之后,我彻底放弃了折腾十几个互相调用的 Agent,也没有去买昂贵的本地 GPU 服务器。
我现在只保留了一个极简的四层结构:
研究者定问题与纳排标准 → AI 分析层出候选方案 → 原始证据层(PDF/档案/Datasheet)与可执行验证层(Python/SPICE)做机器校验 → 人工签字归档。
在硬件和软件预算上,我按十月底的实时价格算了一笔账,其实根本花不了多少钱:
1.如果你是单兵作战,每月 200 元人民币就是最低可行档:订一个主力 AI 会员(ChatGPT Plus 或 Claude Pro 均为 20 美元/月,约合 133 元人民币),配上免费的 Zotero(自带 300 MB 存储,或者直接挂载学校免费的 WebDAV)、ResearchRabbit 免费层、Python + Jupyter + Git,电子方向加个免费的 ngspice 和 KiCad。这套组合已经能吃下约 80% 的日常需求类型。
2.如果是课题组主力用,每月 1000 元人民币的标准档最舒服: 两个主力模型会员(约 266 元),Zotero 升级到 6 GB 方案(每年 60 美元,折合约 33 元/月),按需加上 Scite Basic(年付折合 12 美元/月),剩下的几百块钱全部留作 API 浮动池。
3.日常跑大批量文本清洗或低敏任务,直接调国内 API,比如 Kimi K3.1 Pro 输入只要 13 元/百万 token、输出 68 元/百万 token;遇到极难的推导或投稿前终审,再去调 GPT-6.1 Sol(输入 2 美元/输出 10 美元每百万 token)、GPT-6 Astra(10/50 美元)或者 Claude Opus 5.5(4/20 美元)。
我现在每开一个新课题,本地硬盘只建一个主目录。
Zotero 里的一条记录永远只代表一部原始作品,我自己的批注强制打上 [HUMAN NOTE] 标签,AI 生成的摘要强制打上 [AI SUMMARY:model/date] 标签,物理隔离,绝不混用。
所有的原始实验数据锁死在 data_raw 文件夹并做好 SHA256 校验,禁止任何 AI 脚本直接覆盖。
哪怕是去测不同模型在中文课题上的表现,我也自己攒了一套 50 道题的“小测试集”(20 道文献定位、15 道争议比较、10 道史料语境、10 道学术写作),先自己写出标准答案,再匿名盲测模型,只看“证据定位正确率”,不看谁的文笔更华丽。
只有当某一个纯手工步骤在一个月内原封不动地重复了 5 到 10 次,且验收标准完全固定时,我才会写个 Skill 或脚本把它自动化。
毕竟,ACM 2026 年更新的投稿政策,加上 Springer Nature 九月的政策调整,都已经把话挑明了:AI 参与实验、代码、仿真或数据分析必须明确披露,且所有科学图表和结论必须有可独立核查的原始数据与计算输出兜底。
其实,上边说的那几个会员一年花不了两千块,但是当你把一段自己看不懂的结论写进论文后,等到答辩那天被问住,就下不来台了。